Day 14:把八個工具串起來——從資料到上線
這是什麼、解決什麼問題
Day 6 到 Day 13,我們一天認識一個工具。 但工具會不會用,跟能不能把它們接起來,是兩件事。
今天走一次完整的路:一份資料進去,一個能打的 API 出來。
重點不在每個工具怎麼用(前面講過了), 在於交接點——上一個工具的產出,怎麼變成下一個工具的輸入。 斷掉的地方幾乎都在交接點上。
什麼時候你會用到
- 第一次要把整套跑通
- 要跟別人解釋「我們的流程長什麼樣」
- 要找出「哪一段是人工的」——這是評估自動化程度最快的方法
前置條件
前面十二天的東西都要能動:
oc get dsc default-dsc -o json | jq -r --argjson want '
  ["DashboardReady","KserveReady","WorkbenchesReady","AIPipelinesReady","ModelRegistryReady"]' '
  .status.conditions[] | select(.type as $t | $want|index($t)) | "\(.type)=\(.status)"'
⚠️ 別寫成 test("Dashboard|Kserve|...") 這種模糊比對。
新版多了 KserveLLMInferenceServiceDependencies、WorkbenchesV2Ready
這些同前綴的條件,會一起被撈進來(Day 5 踩過)。
但 False 不等於要停。 我寫這篇那天重跑,ModelRegistryReady=False
(reason: DeployFailed,operator 升版後少拿到一個 RBAC 權限),
可是 registry 的 pod 是 2/2、API 打得通、後面站 5 的註冊照樣成功。
元件 condition 說的是「operator 這次調和順不順」,不是「這個服務能不能用」。 往下走之前看的是實例:pod 起來沒、API 回不回。
全景:七站與六個交接點
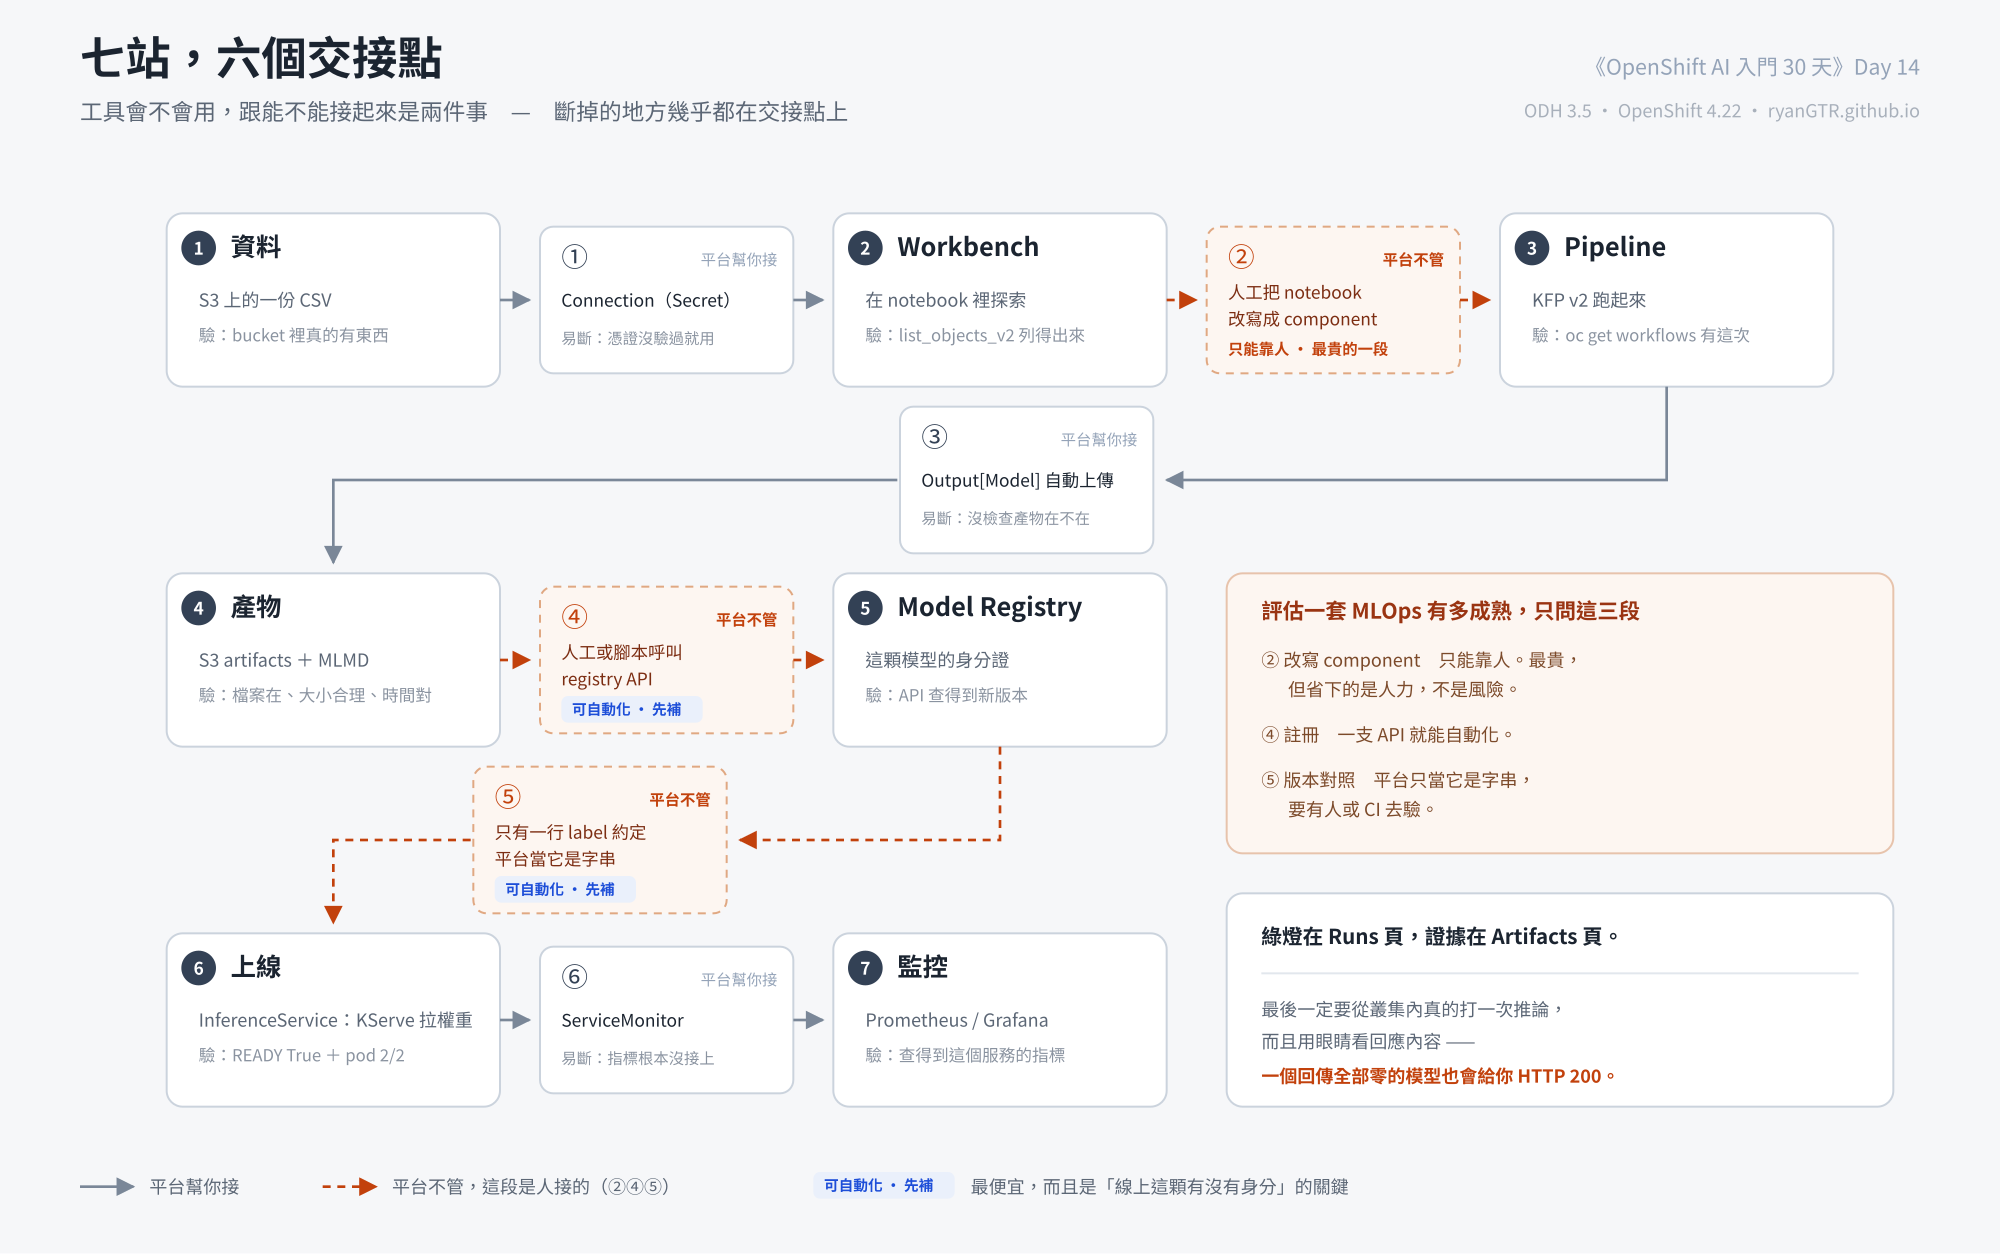
| 交接 | 從 → 到 | 靠什麼接 | 最容易斷在 |
|---|---|---|---|
| ① | 資料 → Workbench | Connection(Secret) | 憑證沒驗過就用 |
| ② | Workbench → Pipeline | 人工把 notebook 改寫成 component | 這裡幾乎都是人工 |
| ③ | Pipeline → 產物 | Output[Model] 自動上傳 S3 |
沒檢查產物存不存在 |
| ④ | 產物 → Registry | 人工或腳本呼叫 API | 常常整段沒有 |
| ⑤ | Registry → ISvc | 只有約定,平台不管 | 版本對不起來 |
| ⑥ | ISvc → 監控 | ServiceMonitor / PodMonitor | 指標沒接上 |
②④⑤ 這三個交接點,平台不會幫你做。 評估一套 MLOps 有多成熟,看的就是這三段是人工還是自動。
其中 ④⑤ 是可以自動化的(在 pipeline 後面多接一棒就好), 而 ② 只能靠人。先補 ④⑤——它們最便宜,而且是「線上這顆模型有沒有身分」的關鍵。 實際寫法在 Day 28。
站 1–2:資料進來,開始探索
# 建 Connection(Day 7)
oc apply -f connection.yaml
# 建 Workbench 時勾選它(Day 8)
交接點 ① 的驗證——不要相信 dashboard 顯示正常,在 workbench 裡真的讀一次:
import os, boto3
s3 = boto3.client("s3", endpoint_url=os.environ["AWS_S3_ENDPOINT"],
    aws_access_key_id=os.environ["AWS_ACCESS_KEY_ID"],
    aws_secret_access_key=os.environ["AWS_SECRET_ACCESS_KEY"])
print([o["Key"] for o in
       s3.list_objects_v2(Bucket=os.environ["AWS_S3_BUCKET"]).get("Contents", [])][:5])
列得出東西才算接上。
⚠️ bucket 名字也是 Connection 給的(AWS_S3_BUCKET),別自己寫死。
寫死而那個 bucket 不存在時,錯誤是 NoSuchBucket——
看起來像憑證問題,其實憑證是對的。
站 3:把 notebook 變成 pipeline(交接點 ②)
這一段是純人工的,而且是整條路上最花時間的一段。
notebook 裡的一格:
df = pd.read_csv("data.csv")
df = df.dropna()
df.to_csv("clean.csv")
變成 pipeline component:
@dsl.component(packages_to_install=["pandas"])
def prepare(raw: dsl.Input[dsl.Dataset], clean: dsl.Output[dsl.Dataset]):
    import pandas as pd                    # ← import 要搬進函式裡
    pd.read_csv(raw.path).dropna().to_csv(clean.path, index=False)
三件事變了:
- 檔案路徑變成
Input/Output物件 - import 要搬進函式(那段程式會被抽到另一個容器跑)
- notebook 裡的全域變數全部不能用了
⚠️ 這一步沒有工具能自動幫你做(有些工具宣稱可以, 但只處理最單純的情況)。排時程時要算進去。
站 4:產物與版本(交接點 ③)
跑完之後,不要只看 run 是不是綠的:
oc get workflows -n <ns> # Argo 的執行實體
⚠️ 這條有保存期限。persistenceagent 把紀錄寫進資料庫之後,
預設 24 小時(TTL_SECONDS_AFTER_WORKFLOW_FINISH=86400)就把 workflow 物件刪掉。
所以 oc get workflows 回 No resources found 不代表沒跑過,
只代表過期了——事後要查,去 Runs 頁或走 API。
(要留久一點:DSPA 的 spec.apiServer.resourceTTL。)
去 dashboard 的 Artifacts 分頁,看:
- 檔案在不在
- 大小合不合理(一個 5 MB 的模型跟一個 32 MB 的模型不是同一個東西)
- 時間戳是不是這次跑的
我寫這篇時真的送了一次 run 去看。上面那個 prepare 的產物落在:
pipelines/day14-handoff/<run-id>/make-raw/<執行 id>/raw     30 bytes
pipelines/day14-handoff/<run-id>/prepare/<執行 id>/clean    20 bytes
30 → 20 這個數字本身就是一次檢查:進去 4 列、有兩列帶空值,
出來剩 2 列,檔案該變小。如果 clean 跟 raw 一樣大,
dropna() 那行大概沒作用——而 run 一樣是綠的。
(每個 step 旁邊還會多一份 executor-logs-0,卡住時先看它。)
綠燈在 Runs 頁,證據在 Artifacts 頁。 這是我在這個平台上學到最有用的一句話。
站 5:註冊(交接點 ④)
TOKEN=$(oc whoami -t)
BASE=https://<registry route>/api/model_registry/v1alpha3
curl -sk -X POST "$BASE/model_versions" \
  -H "Authorization: Bearer $TOKEN" -H 'Content-Type: application/json' \
  -d '{"name":"v3","registeredModelId":"1","author":"pipeline"}'
這一段最常整個不存在。 因為跳過它,模型照樣上線。
要自動化的話,就在 pipeline 最後加一個 component 呼叫這個 API。 加上去的那天,你才真的有一份可信的清單。
⚠️ 版本名重複會回 409。pipeline 重跑一次就撞得到——
版本名要帶 run id 之類會變的東西,不要寫死 v3。
站 6:上線(交接點 ⑤)
apiVersion: serving.kserve.io/v1beta1
kind: InferenceService
metadata:
  name: my-model
  labels:
    model-registry/version: "v3"      # ← 交接點 ⑤ 就靠這一行
spec:
  predictor:
    model:
      modelFormat: { name: onnx }
      storageUri: s3://models/my-model/v3/
⚠️ 平台不會檢查這個 label 跟 registry 對不對得上。 它只是個字串。要它有意義,得有人(或 CI)去驗。
站 7:監控(交接點 ⑥)
模型服務要暴露 metrics,然後要有東西去抓。
先確認你有沒有 metrics Service——不是每個 ISvc 都會有:
oc get svc | grep metrics
我這台三個 ISvc,只有走具名 ServingRuntime(sklearn/mlserver)的那個有
<isvc>-metrics;另外兩個是自己打包的容器、沒指定 runtime,連 metrics Service 都沒有。
沒有的話下面這份 ServiceMonitor 指誰都沒用,要先讓服務自己把 /metrics 開出來。
有的話,加一個 ServiceMonitor 指它:
apiVersion: monitoring.coreos.com/v1
kind: ServiceMonitor
metadata:
  name: my-model
spec:
  selector:
    matchLabels: { name: my-model-metrics }   # ← 選的是 Service 的 label
  endpoints:
  - port: mlserver-runtime-metrics            # ← port 名字由 runtime 決定
這兩行我原本都寫錯,而且錯得一點聲音都沒有。
原本寫的是 matchLabels: { serving.kserve.io/inferenceservice: my-model }
配 port: metrics:
serving.kserve.io/inferenceservice是 predictor Service 的 label, 而 predictor Service 只有一個叫http的 port——選得到 Service,選不到 port- metrics Service 的 label 是
name: <isvc>-metrics, 而 port 名字是跟著 ServingRuntime 的名字走的:我這台 runtime 叫mlserver-runtime,port 就叫mlserver-runtime-metrics。 換一個 runtime 名字就變了——這行不能照抄,要自己oc get svc -o yaml看
oc apply 兩種寫法都會成功,沒有任何警告。
ServiceMonitor 寫錯,行為就是安靜地抓不到東西。
⚠️ 還有第三層:要有人讀它才算數。 OpenShift 內建監控預設不看使用者
namespace,那份要另外打開(cluster-monitoring-config 的 enableUserWorkload)。
沒打開的話,這份 YAML 就只是叢集裡的一筆資料——我這台 lab 就是這樣,
真正在抓的是我自己裝的一顆 Prometheus,它用 static config,連 ServiceMonitor 都不讀。
驗證方式只有一個:去 Prometheus 的 Targets 頁看它在不在, 不是看 YAML 有沒有套進去。
Day 17 會細講要看哪四個指標。
怎麼確認整條路通了
一條一條驗,不要只看最後有沒有回應。
| 站 | 一句話驗證 |
|---|---|
| 1–2 | workbench 裡 list_objects_v2 列得出東西 |
| 3 | oc get workflows 有這次的執行 |
| 4 | Artifacts 頁有檔案,大小合理 |
| 5 | registry API 查得到新版本 |
| 6 | oc get isvc READY True + pod 2/2(kserve-container + kube-rbac-proxy) |
| 7 | Prometheus 的 Targets 頁看得到這個 Service 且 UP(不是「ServiceMonitor 有建」) |
⭐ 最後再做一次真正的端到端驗證:
# 從叢集內打一次真的推論請求(這是我這台 iris 模型的實際輸入)
oc run t --rm -i --restart=Never -n <ns> --image=curlimages/curl -- \
  curl -s -X POST http://my-model-predictor.<ns>.svc.cluster.local/v2/models/my-model/infer \
  -H 'Content-Type: application/json' \
  -d '{"inputs":[{"name":"input-0","shape":[1,4],"datatype":"FP32",
       "data":[5.1,3.5,1.4,0.2]}]}'
叢集內走 Service 的 80 埠是直接進到模型容器的,不經過旁邊那個
kube-rbac-proxy(它聽 8443),所以這一發不用帶 token。
回來的東西長這樣:
{"model_name":"my-model","outputs":[{"name":"predict","shape":[1,1],
 "datatype":"INT64","data":[0]}]}
回應內容要用眼睛看過。 HTTP 200 不代表結果是對的。
這個 0 是 setosa,剛好是對的;
但一個壞掉的模型永遠回傳 0,長得一模一樣,也一樣給你 200。
常見問題
Q:一定要照這個順序嗎? A:不用。很多團隊是先把模型上線(站 6), 之後才回頭補 pipeline 和 registry。這樣沒錯,但要知道自己欠了什麼。
Q:這條路跑一次要多久? A:第一次連通我花了好幾天,多數時間卡在交接點而不是工具本身。 熟了之後,換一個模型跑完全程大約半天——前提是站 3 那段程式碼不用重寫。
Q:哪一段最該先自動化? A:交接點 ④(註冊)。它最便宜(一支 API 呼叫), 而且是唯一能讓你回答「線上是哪版」的東西。 交接點 ② 最貴,但省下的是人力不是風險。
你們這條路上,哪一段是人工接的?
🧪 這篇的實驗環境與 lab 檔案(最後更新 2026-08-30)
叢集
- CRC 2.63.0 · OpenShift 4.22.7 · Kubernetes v1.35.6
- 單節點:13 vCPU / 40 GiB RAM / 120 GB disk
- 宿主:Framework Laptop 16(Ryzen AI 7 350 · 8C/16T · 64 GB RAM · 1 TB NVMe · RTX 5070 顯卡模組)
- ⚠️ 叢集內看不到 GPU(CRC 是 VM,RTX 5070 未 passthrough)
Operator
opendatahub-operator.v3.5.0← 即 RHOAI 3.x 的上游開源版cert-manager-operator.v1.20.0(3.x 的必要相依;2.x 不需要)openshift-pipelines-operator-rh.v1.23.2、openshift-gitops-operator.v1.21.3
DataScienceCluster 開啟的元件
kserve、aipipelines、dashboard、workbenches、modelregistry、kueue(Unmanaged)- 其餘(
ray/trustyai/feast/aigateway…)為Removed
叢集外的依賴(跑在宿主的 podman 上,crc start 不會帶起來)
- Harbor v2.15.2(私有 registry)· MinIO(S3)
模型端
- Python 3.12.13 · PyTorch 2.11.0+cu128 · FastAPI + uvicorn · prometheus-client
lab 檔案
- YAML/Containerfile/腳本:github.com/ryanGTR/openshift-ai-30days
(含 Day 對照表;主機名是佔位符,跑
set-lab-host.sh換成你自己的) - 服務的那個模型:llm-from-scratch(從零手刻的小 GPT)
⚠️ ODH ≠ RHOAI:元件同源,但 namespace 與部分名稱不同
(我這裡是 opendatahub,商用版是 redhat-ods-* 那一套)。
指令的邏輯可以照用,字串要自己對一次。
留言與指正
我特別想知道:你們這條路上,哪一段是人工接的?